
独创RSI驱动双循环,Tiri Agent金融领域强势超越Claude Code
作者 EasyLink
昨天,我们公布了一组测评数据:
在 Finance Agent v2 公开测试集上,Tiri Agent 依托一个 27B 模型,取得了 **71.25%**的综合得分。而在公开榜单中,Claude Fable 5.1 为 58.9%,GPT-6 Astra 为 53.5%。
让一个 27B 规模的模型在特定领域超越通用的顶尖旗舰模型,这一结果引发了很多朋友的关注。
发布之后,许多朋友与我们交流,关注焦点高度一致:在模型参数并不占优的前提下,这样的性能突破究竟是如何实现的?
为了系统性回应大家的关注,我们开展了一组控制变量的对照实验。
在保持底层 27B 模型与 Finance Agent v2 公开测试集完全一致的前提下,对比 Tiri Agent Harness 与 Claude Code Harness 的表现:
- Tiri Agent:71.25%
- Claude Code:57.68%
评测结果分析
按九大类金融题型进行细分拆解,Tiri Harness 的性能提升主要体现在:
核心优势集中于财务建模(+50.86%)、披露分析(+44.44%)与可比公司分析(+33.33%)这类高度依赖数据统一性的场景;
在一般定量分析与盈利分析两类场景中,Tiri Agent Harness 和 Claude Code 表现持平;
在一般定性分析、市场分析、先例交易分析等以信息阅读与归纳为主的题型中,Tiri Agent 略高于 Claude Code;
这一结果说明,27B 的小模型在文本理解与信息抓取层面并不构成瓶颈;真正的胜负手,集中在“数据如何取,口径怎么定”这一环节。
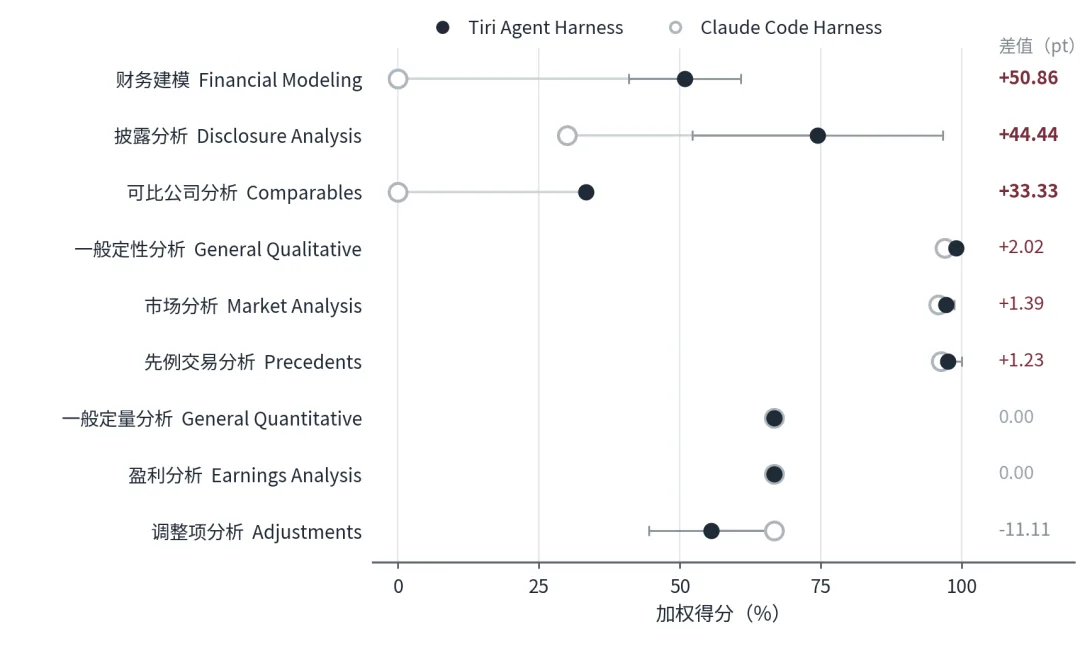
图 1:分题型加权得分对比
(Tiri Agent Harness 采用三次独立运行均值,误差线为标准误)
典型 Case 剖析:
可比公司分析中的“固定费用覆盖率”判定
“可比公司分析”中的固定费用覆盖率(Fixed-Charge Coverage Ratio)计算题,最直观地展示了 Tiri Agent 和 Claude Code 的架构级差异。
题目要求计算 EBITDAR 除以固定费用(利息费用与固定经营租赁成本之和),对塔吉特(Target)与沃尔玛(Walmart)进行横向可比分析。
其中,租金部分题干已明确给出,Walmart 的 23.47 亿美元为扣除浮动与短期部分后的固定租赁成本。真正的难点在于利息口径的对齐:
- Target 的利润表仅列示了“利息净额”(4.11 亿美元);
- Walmart 的财报中则同时存在“利息净额”(22.45 亿美元)与“利息总额”(27.28 亿美元)两个指标。
由于覆盖率是一个比值,若对两家公司分别采用“净额”与“总额”口径,计算出的结果便彻底丧失了横向可比性。
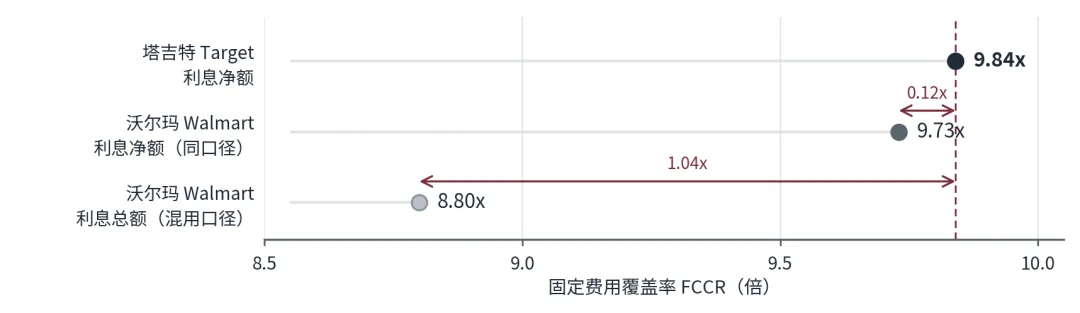
图 2:同一题目下的两种利息口径对齐方案
Target分子与分母均采用利息净额,得值为 9.84x;若 Walmart 错误切换为利息总额口径,其与 Target(9.73x)的差值将从 0.12x 放大至 1.04x,导致对比结论完全失真。
Tiri Agent 在计算启动前,首先显式确立三条全局计算约定:
- EBITDA 维度:统一取现金流量表中的完整折旧与摊销(鉴于零售企业会将部分折旧计入营业成本,导致利润表对应行存在少计风险);
- 利息维度:统一取各公司利润表中主表列示的对应行口径;
- 租金维度:严格遵循题干给定的特定口径。
该规范一次性作用于两家公司,确保后续所有定量计算均在同一标准下展开。
Claude Code 检索链路同样完整,不仅追溯到了租赁附注与利息收入,也算出了 9.73x 的结果。但由于缺乏“跨标的计算口径必须强制对齐”的规则约束,两种不一致的口径被同时保留在上下文环境中,最终导致模型在推理阶段自行做出了主观取舍。
由此可见,Tiri Agent 和 Claude Code 的表现差异既不在于检索深度,也不在于算术能力。
这也恰恰证明了后文即将展开的“符号规则注入(Symbolic Rule Injection)”在消除概率随机性方面的必要性。
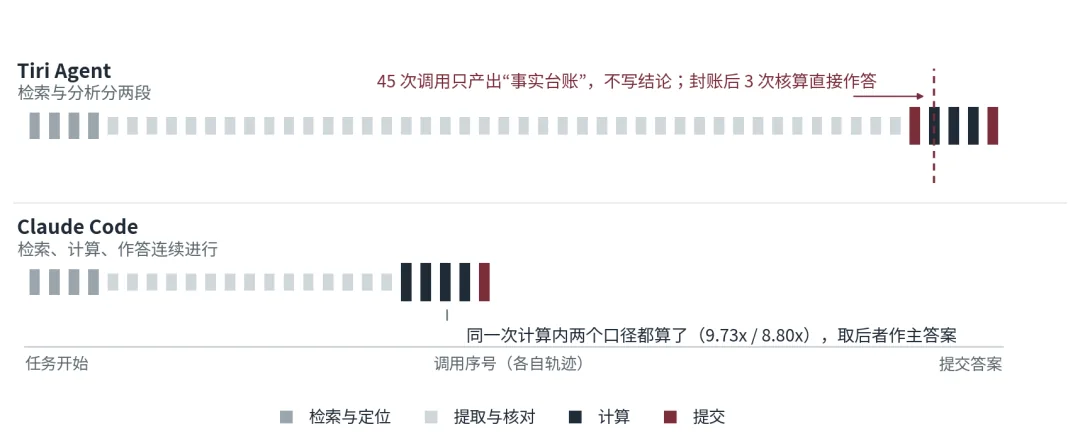
图 3:同一题目的完整执行轨迹对比
(横轴为工具调用序号)
从执行轨迹可以看出,Tiri Harness 在检索阶段与分析作答阶段之间设定了明确的阶段硬隔离;Claude Code 则表现出连续交织的混合推进状态。
虽然双阶段隔离机制消耗了更多的调用轮次与执行时间,但在单题 Token 成本基本持平的前提下,Tiri 以确定性的工程成本,换取了计算口径的严谨性与合规性。
拆解 Tiri Harness 的底层架构差异
上述分析结果表明,Tiri 的高分并非来自单一环节的突破,而是源于 RSI(递归自我改进)机制下,Harness 与模型协同演进的系统工程。
这一优势来自于三个核心架构差异:
01 检索与分析解耦的二阶段 Harness,构建防幻觉硬隔离
传统单 Harness 架构在检索信息的同时会自动形成偏好判断,这极易导致认知偏差。后续检索会倾向于寻找支持既有假设的证据,而忽略反向证据。
Tiri 采用了二阶段 Harness 设计,将金融任务中的两个角色解耦:
- 研究员(Researcher):仅负责搜集并输出严格的“证据台账”,包含信息来源、精准定位及原文片段,严禁得出分析结论。
- 分析师(Analyst):仅基于已核验的台账进行推理与作答,无法接触原始检索过程。
这种机制确保分析结论完全依赖于可查证的客观台账,剥离了检索过程中的主观印象干扰。
02 符号规则注入,将行业隐性共识转化为可定位的显性知识
流通股与已发行股的区别、单季与累计口径的切换、并表范围的界定以及拆股调整……这些行业惯例和“know-how”属于金融领域的隐性共识,往往不会写在单一文档中。
由于训练语料本身存在大量口径不一致,模型在此类问题上极易产生高置信度的错误判断。
Tiri Harness 选择了将这些隐性共识转化为符号规则注入,把行业惯例显式编写为“规则卡片”,用于约束 Agent 回答的口径和格式规范,并在逻辑链中进行冲突检测。
这种机制使得 Agent 能够稳定、准确地遵循金融行业的管理完成任务。
03 以 RSI 驱动,构建 Harness 与模型的一体化迭代机制
业界常见的模式是将 Agent 框架视作固定的执行环境,模型在其中单独训练。
Tiri 抛弃了这种静态隔离的演进模式,将 Harness 与模型置于同一套验证标准与统一数据形态之下,通过“运行态”与“训练态”的双循环闭环,真正实现了系统级的递归自我改进(RSI)。
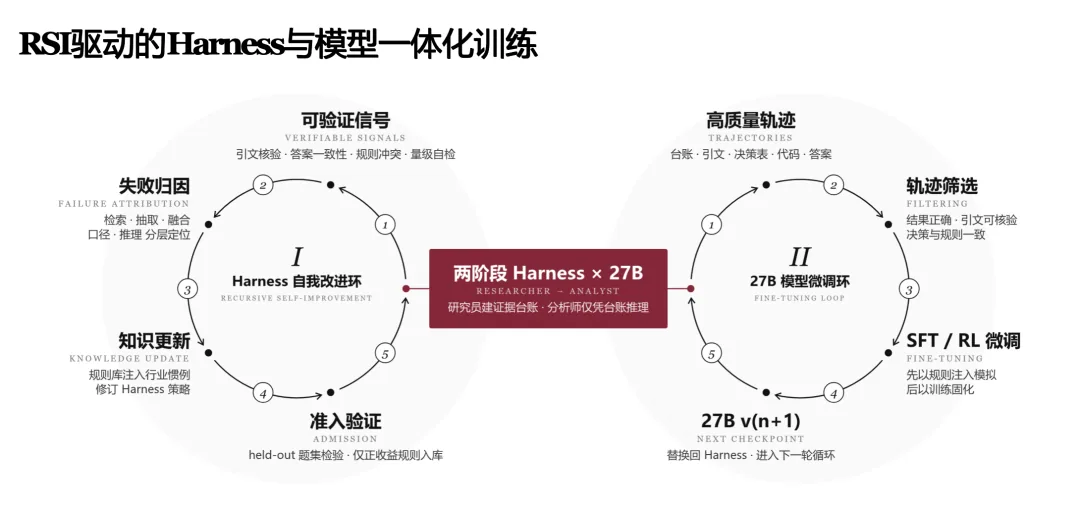
在这一 RSI 架构中,Harness 与模型的协同演进体现在三个关键维度:
全链路数据沉淀
任务执行过程中留下的完整轨迹数据,包括证据台账、决策表、校验代码及最终答案等,天然具备高质量微调数据的要求,无需人工标注,即可直接转化为驱动模型进化的训练语料。
基于硬信号的数据筛选与强化
Agent Runtime 触发的校验信号(引文能否核验、前后逻辑一致性、规则命中情况),无缝接入模型的训练流水线。
这些信号既是 Harness 判定是否重做的门禁,也直接作为模型训练阶段的数据筛选过滤机制与强化学习的可验证奖励信号(RVR / Verifiable Reward)。
Harness 与模型动态进化
新知识首先以规则形式在 Harness 层验证其有效性,成熟后再逐步固化至模型微调集。
反之,当模型在迭代中展现出更强的隐式推理能力后,Harness 亦可精准评估并安全撤除已被模型内化的冗余规则。
从资产属性的角度来看:模型权重属于不可直接审计的“黑盒资产”,而 Harness 规则库则是完全可审计的“白盒资产”。
先通过白盒规则验证逻辑,再将成熟知识固化入权重,极大地提升了系统的可控性与演进效率。
结语:追求可信优先的系统工程,低成本打造更高的金融智能
当前行业内存在另一条极具代表性的技术路线:将金融 Agent 理解为端到端的训练问题,利用大规模合成数据与可验证奖励,试图直接将行业惯例与逻辑压入模型权重中。
在数据高度标准化、任务边界极其清晰的特定场景下,该路线具备较高的效率。
而我们选择了另一条路径:首先承认大模型内部存在符号逻辑难以直接统摄的区域,通过工程规则划定明确的行为边界并完成验证,再审慎地决定将哪些知识沉淀入权重。
这种路径不仅能使整个训练和优化的过程更透明、可审计,还可以用更低的成本实现更高的智能。
前者追求的是更强的单体模型,后者追求的是更可信的生产级系统。
在复杂高陡峭度的金融业务场景中,我们坚信后者的商业价值与交付确定性能更早兑现。
大模型目前已经跨越了可用的临界点,但距离企业级可交付依然存在显著的工程鸿沟。我们深知技术路线的演进日新月异,但面对高确定性要求的大金融场景,将确定性还给工程,将创造力留给模型,是我们坚定不移的解题思路。
我们也将沿着这条道路,持续以金融 AGI 为目标,将智能体可靠性推向极致。
相关文章
 博客文章
你的 AI 有记忆吗?从知识图谱到混合智能,企业知识组织的下一个十年
当 DevRev 的 CEO 在台上抛出"你的 AI Agent 有记忆吗?"这个问题时,台下沉默了三秒。这三秒里,所有人都在想同一件事:我们花了大价钱部署的 AI 系统,到底是真
 博客文章
全能Agent离业务落地还有多远?看OpenClaw如何集成EasyLink轻松搞定复杂文档解析
最近,一只来自奥地利的大龙虾(OpenClaw)频繁霸榜热搜,引来无数网友围观,目前Github上已斩获18万Star。
 博客文章
文档处理进入"语义理解"时代:EasyLink三级处理体系如何为企业AI应用筑基?
在大模型技术迅猛发展的今天,企业面对海量非结构化文档时仍面临核心瓶颈:如何将复杂版式的文档转化为机器可真实理解的语义信息。传统OCR技术作为计算机的"眼睛",仅能完成字符层面的识别
体验 Tiri,让 AI 帮你工作
免费开始